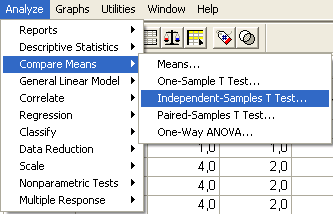
Процедура 5.1. Изчисляване на t-критерия за независими извадки
Процедура 5.2. Изчисляване на F-критерия на Фишер
Сравнете броя на отбелязаните (n1) и допуснатите голове (z1), дългите (n8), късите (n9) и общия брой на пасовете (n10) при финалисти и останалите участници в турнира (kateg) с помощта на t-критерия на Стюдънт за независими извадки.
Запишете резултатите в изпитния проект (тема 5).
Характерна особеност на SPSS е, че за изчисляване на t–критерия на Стюдънт за независими извадки, данните за двете сравнявани групи (мъже-жени, експериментална-контролна група, финалисти-останали участници и др.) трябва да бъдат въведени в една колона. Тази променлива се нарича Test Variable. В същото време се въвежда една групираща променлива, в която с код (в примера 1-финалисти, 2-останали участници) се отбелязва към коя от групите принадлежи съответното изследвано лице. Тази променлива е означена с Grouping Variable.
1. Изберете Analyze> Compare Means > Independent Samples T Test (фиг.5.1) – отваря се диалоговият прозорец Independent Samples T Test (фиг.5.2).
Фиг. 5.1.
2. Маркирайте променливите, за които желаете да бъде проверена хипотезата за равенство на средните. Натиснете бутона със стрелката, сочеща към полето Test Variables - променливите се прехвърлят в списъка за обработка.
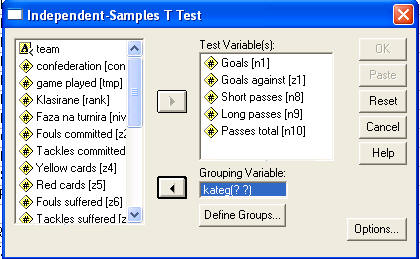
Фиг. 5.2.
3. Маркирайте групиращата променлива (в случая kateg), натиснете бутона със стрелката, сочеща към полето Grouping Variable – тя се прехвърля там, придружена от символа (? ?), което означава, че програмата се нуждае от потвърждение за кодовете, с които са въведени сравняваните групи.
4. Натиснете бутона Define Groups – отваря се вторичният диалогов прозорец Define Groups (фиг. 5.3).
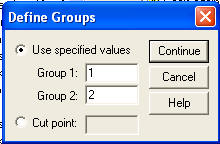
Фиг. 5.3
5. На реда Group 1 запишете кода, с който е въведена едната група, а на реда Group 2 – на другата група, както е показано на фигурата. Излезте от диалоговия прозорец Define Groups като натиснете бутона Continue.
6. Стартирайте изпълнението на командата с бутона ОК.
Разпечатката на SPSS е представена в две таблици. В първата е направена характеристика на разпределението на признака в двете сравнявани групи (фиг.5.4). По-важните статистически показатели са:
1 - брой на изследваните лица (Number of Cases)
2 - средна аритметична (Mean)
3 - стандартно отклонение (Std. Deviation)
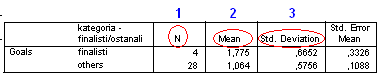
Фиг. 5.4.
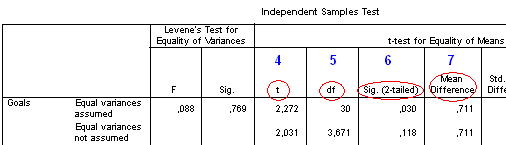
Фиг. 5.5.
Във втората част от разпечатката (фиг. 5.5) са поместени стойностите на t-критерия на Стюдънт (4).
Забележка: Едно от условията за използване на t–критерия на Стюдънт за независими извадки е дисперсиите на признака в двете извадки да бъдат приблизително еднакви. Информация за това сравнение дава тестът на Левене (фиг. 5.5). Ако равнището на значимост (означено в случая със Sig.) на този ред е по-малко от 0,05 разликата в дисперсиите на признака е статистически достоверна. Ако, както е в случая Sig=0.769, се счита, че дисперсиите на двете извадки са еднакви. Ако от тестът на Левене е установено, че дисперсиите са равни, се ползва стойността на реда Equal, в противен случай – от реда Unequal.
Там са изписани също така степените на свобода (df - 5), достигнатото равнище на значимост (2-Tail Sig - 6) и разликата между сравняваните емпирични средни стойности. По данните от примера, емпиричната стойност на t–критерия (temp ) за броя на отбелязаните голове (Goals) е 2,272.
Резултатите от проверката на хипотези за независими извадки се представят в научни публикации по следния начин (таблица 5.2):
В колона Показател са изписани изследваните променливи.
В следващите колони е направена характеристика на разпределението на признака в двете сравнявани групи.
В колона d е изписана аритметичната разлика в сравняваните средни стойности.
В колона t - емпиричната стойност на t-критерия на Стюдънт.
В колона P/t/ достигнатата гаранционна вероятност. Ще припомним, че ако P/t/ е по-голямо или равно на 95% - разликата се приема за статистически значима.
За удобство при ползване на научни публикации, в които е представен резултат от проверката на хипотези, под формата на забележка под таблицата, се изписва табличната стойност на критерия.
Таблица 5.2.
|
Показател |
Финалисти |
Останали участници в турнира |
d |
t |
P(t) |
|||||
|
n1 |
`C1 |
S1 |
n2 |
`C2 |
S2 |
|||||
|
1 |
Goals |
4 |
1,78 |
0,67 |
28 |
1,06 |
0,58 |
0,71 |
2,27 |
96,96 |
|
2 |
Goals against |
4 |
0,68 |
0,24 |
28 |
1,49 |
0,74 |
-0,79 |
2,09 |
95,52 |
|
3 |
Short passes |
4 |
304,46 |
31,19 |
28 |
286,30 |
54,32 |
18,15 |
0,65 |
47,75 |
|
4 |
Long passes |
4 |
119,75 |
12,74 |
28 |
137,10 |
21,14 |
-17,35 |
1,59 |
87,68 |
|
5 |
Passes total |
4 |
424,23 |
33,86 |
28 |
423,40 |
60,92 |
0,83 |
0,03 |
2,08 |
Забележка: Критичната стойност на t-критерия на Стюдънт при k=n1+n2-2=30 и a=0,05 е равна на 2,04 (виж приложение 8).
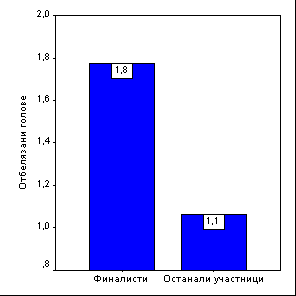
Фиг. 5.6.
Подходящи графични изображения за онагледяване на резултати от проверка на хипотези за независими извадки са box-plot или стълбовидните диаграми (фиг. 5.6).
Сравнете броя на отбелязаните (n1) и допуснатите голове (z1) при участници в различни фази на турнира (nivo).
Запишете резултатите в изпитния проект.
Както при изчисляване на t–критерия на Стюдънт за независими извадки, данните на всички сравнявани групи трябва да бъдат въведени в една колона, като тази променлива се нарича зависима. В същото време факторната променлива (която, както вече бе посочено в терминологията трябва да е номинално или рангово скалирана) съдържа кодове, показващи принадлежността на обектите към съответната група.
1. Изберете Analyze> Compare Means>One-Way ANOVA – отваря се диалоговият прозорец One-Way ANOVA (фиг. 5.7).
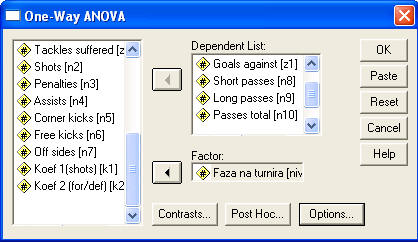
Фиг. 5.7
2. Маркирайте зависимите променливи, натиснете бутона, сочещ към полето Dependent List – те се прехвърлят в него.
3. Маркирайте факторната променлива, натиснете бутона, сочещ към полето Factor – тя се появява там.
4. Ако желаете да бъде направен вариационен анализ за всяка от сравняваните групи влезте в Options и активирайте Descriptive (фиг. 5.8). Излезте от диалоговия прозорец, като натиснете Continue.
.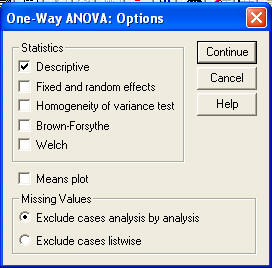
Фиг. 5.8.
5. Стартирайте изпълнението на командата с ОК.
Разпечатката на SPSS е съставена от две таблици. Първата (фиг. 5.9) се появява само в случай, че сте задали вариационен анализ на променливите (стъпка 4). В нея е представена информация за:
1 - броя на наблюденията във всяка от групите (N)
2 - средните стойности на всяка от сравняваните групи (Mean)
3 - стандартните отклонения (Std. Deviation)
4 - минималната стойност
5 - максималната стойност
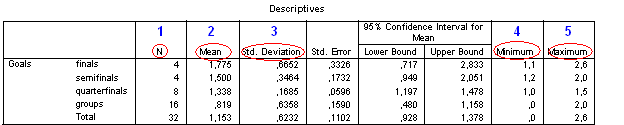
Фиг. 5.9.
Във втората част на разпечатката фиг. 5.10) са представени резултатите от дисперсионния анализ:
6 - степените на свобода (df)
7 - емпиричната стойност на F-критерия на Фишер (F)
8 - достигнатото равнище на значимост (Sig.)
В представения пример, различията в броя на отбелязаните голове при отборите, отпаднали на различна фаза на СП е статистически значима, защото равнището на значимост е 0,008 (по малко от 0,05).
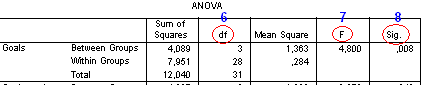
Фиг. 5.10.
При представяне на резултати от дисперсионен анализ в научни публикации е уместно значително опростяване на таблиците. Считаме за уместен начина, представен в табл. 5.3.
Таблица 5.3
|
Показател |
Фаза |
`C |
S |
F |
P/F/ |
|
Goals |
finals |
1,80 |
0,67 |
4,80 |
99,2 |
|
semifinals |
1,50 |
0,35 |
|||
|
quarterfinals |
1,34 |
0,17 |
|||
|
groups |
0,82 |
0,64 |
|||
|
Общо |
1,15 |
0,62 |
|||
|
Goals against |
finals |
0,70 |
0,24 |
2.978 |
95,2 |
|
semifinals |
1,05 |
0,34 |
|||
|
quarterfinals |
1,26 |
0,39 |
|||
|
groups |
1,71 |
0,87 |
|||
|
Общо |
1,39 |
0,74 |
|||
|
Short passes |
finals |
304,45 |
31,19 |
0,212 |
11,3 |
|
semifinals |
290,70 |
76,46 |
|||
|
quarterfinals |
278,40 |
57,61 |
|||
|
groups |
289,16 |
50,45 |
|||
|
Общо |
288,57 |
51,97 |
|||
|
Long passes |
finals |
119,75 |
12,74 |
2,82 |
94,3 |
|
semifinals |
131,05 |
12,89 |
|||
|
quarterfinals |
150,80 |
20,68 |
|||
|
groups |
131,76 |
20,77 |
|||
|
Общо |
134,93 |
20,95 |
|||
|
Passes total |
finals |
424,23 |
33,86 |
0,034 |
0,9 |
|
semifinals |
421,75 |
82,94 |
|||
|
quarterfinals |
429,19 |
64,73 |
|||
|
groups |
420,92 |
57,65 |
|||
|
Общо |
423,50 |
57,82 |
Забележка: Критичната стойност на F-критерия на Фишер при k1=3, k2=29 и a=0.05 е равна на 2.95
(виж приложение 9).
Поднасянето на информацията в графичен вид значително допринася за нейното добро възприемане. Особено подходяща за случая e box-plot диаграмата (фиг. 5.11), защото освен визуална представя за средното равнище, тя илюстрира и разсейването на стойностите във всяка от групите.
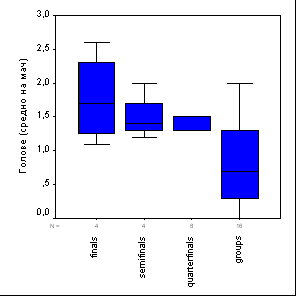
Фиг. 5.11.