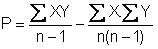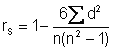
4.2.1. Коефициент на обикновена линейна корелация
4.2.2. Коефициент на рангова корелация
Статистиката изучава зависимостите, проявяващи се в масовите явления. При тях връзката между явлението “фактор” и явлението “резултат” се съдържа във всеки отделен случай, но може да бъде доловена само на базата на масово наблюдение. Единствено тогава се елиминира влиянието на случайните фактори и се проявява закономерната връзка между изучаваните явления.
Целта на голяма част от научните изследвания се състои в разкриване на факторите на спортното постижение, изграждане на модели за оптимизирането и прогнозирането му. За решаване на проблеми от подобен характер се използват статистическите методи за изследване на зависимости.
Понятието зависимост означава връзка между две или повече променливи величини. Когато зависимостта е изразена математически, тя се нарича функция. Най-общият аналитичен вид на една зависимост е: Y=f(X), където X и Y са променливите величини:
Х се нарича аргумент на функцията или независима променлива.
У е зависима променлива (тъй като се предполага, че зависи от Х) или функция.
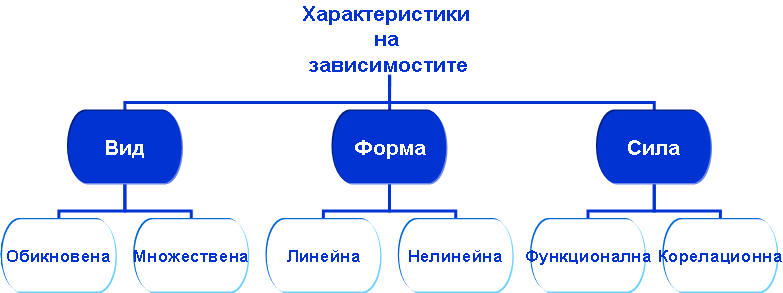
Основните характеристики на зависимостите са вид, форма и сила. Тъй като те са изучавани в бакалавърската степен, на фиг. 4.1 е направено съвсем кратко тяхно описание.
Фиг. 4.1.
В зависимост от броя на факторите, които се изследват:
Обикновена - Изследва се влиянието на един фактор: Y=f(X).
Множествена - Изследва се влиянието на два или повече фактора Y=f(X1,X2….Xm).
В зависимост от математическия и графичен модел на зависимостта:
Линейна - Промяната на фактора (X) води до пропорционална промяна на функцията (Y). Графиката е права линия.
Криволинейна - Промяната на фактора (X), води до непропорционална промяна в Y. Графиката е крива линия.
В зависимост от степента на съвпадение на фактическите стойности на Y с теоретичните
Функционална - Пълна зависимост – в регресионния модел участват всички фактори, влияещи върху Y.
Корелационна - Непълна зависимост - в регресионния модел не участват всички фактори, влияещи върху Y, а само част от тях.
Разграничаването на зависимостите по тези характеристики е твърде важно, тъй като подходите за анализ, статистическите показатели, които се изчисляват и интерпретират, при всяка една от тези разновидности са различни.
Когато се проучват зависимости, обикновено се поставят две основни познавателни задачи:
Да се изследва формата на зависимостта и се опише математически връзката между променливите величини (т.е. да се изчисли аналитичният вид на функцията). Тази задача се решава посредством регресионния анализ.
Да се установи силата на зависимостта, за което се използва корелационният анализ
Състоянието или поведението на човека в условията на спорта, се формира под въздействието на множество фактори. Като се изследва влиянието само на един или няколко от тях не е възможно да се предвиди точно състоянието на явлението “резултат”. Поради това зависимостите са непълни или корелационни.
Основната задача на корелационния анализ е да опише количествено силата (теснотата) на корелационните зависимости. Статистическите показатели, които носят тази информация, се наричат коефициенти на корелация. Те заемат стойности от –1 до +1.
Абсолютната стойност на коефициента носи информация за силата (степента) на зависимост между Х и Y, както е описано в таблица 4.1.
Таблица 4.1
|
Стойност на | r | |
Сила (степен) на зависимост |
|
r=0 |
Липсва зависимост |
|
До 0,3 |
Слаба |
|
От 0,3 до 0,5 |
Умерена |
|
От 0,5 до 0,7 |
Значителна |
|
От 0,7 до 0,9 |
Голяма |
|
Над 0,9 |
Много голяма |
|
r=1 |
Функционална зависимост |
В случай че става дума за линейна зависимост, на интерпретация се подлага и знакът на коефициента на корелация – той носи информация за посоката на зависимостта:
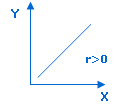
При r > 0 зависимостта е възходяща (еднопосочна) - на по-големи стойности на явлението “фактор” (Х) отговарят по-големи стойности на явлението “резултат” (Y).
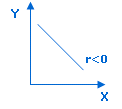
При r < 0 зависимостта е низходяща (разнопосочна) – нарастването на стойностите на Х води до намаляване на стойностите на Y.
Логиката на корелационните коефициенти може да бъде пояснена и по друг начин. Стойностите на зависимата променлива (Y) варират под влияние на различни фактори. Една част от тяхното разсейване се обяснява с влиянието на независимата променлива (Х), а останалата – с влиянието на други фактори. Колкото по-силна е зависимостта между променливите – толкова по-голяма част от дисперсията на стойностите на Y се дължи на влиянието на Х, а съответно по-малка – на неизследваните фактори.
Коефициентът на детерминация (r2), който е равен на квадрата на коефициента на корелация, описва т. нар. обяснена дисперсия. Той показва каква част от вариацията на Y се дължи на различията в стойностите на Х, т.е. на влиянието на изучавания фактор. Ако се умножи по 100, изразява силата на влияние на зависимата променлива в проценти.
Коефициентът на неопределеност (k2) описва влиянието на невключените в изследването фактори, на които се дължи т. нар. необяснена дисперсия. Стойността му се получава, като от общата дисперсия на променливата Y, изразена като единица (100%), се извади обяснената с помощта на коефициента на детерминация (r2). С други думи k2 = 1 - r2. Очевидно е, че колкото по-силна е зависимостта между променливите величини, толкова обяснената дисперсия е по-голяма, а необяснената – по-малка.
В зависимост от вида и формата на зависимостта, както и от начина на скалиране на променливите величини, в практиката се използват различни коефициенти на корелация. На фиг. 4.2 е направен преглед на най-често използваните коефициенти.
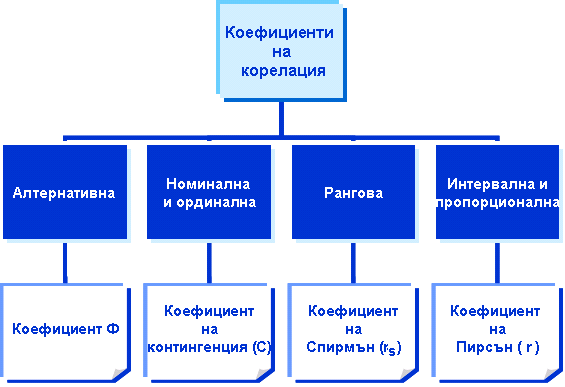
Фиг. 4.2.
Той се прилага се прилага в случай, че зависимостта е:
обикновена по вид, т.е. изследва се връзката между две променливи величини.
линейна по форма, т. е. предварителната проверка е доказала линейния характер на връзката между променливите.
признаците Х и Y са представени в пропорционална или интервална скала.
Стойността на коефициента на Пирсън (r) се изчислява по следната формула:
|
|
(4.1) |
където: Р – момент на произведенията SX – стандартно отклонение на променливата Х SY – стандартно отклонение на променливата Y |
Моментът на произведенията (Р) се изчислява по формула:
|
|
(4.2) |
Където: SХ – сумата на стойностите на Х SY – сумата на стойностите на Y SXY – сумата на произведенията на Х и Y |
Използването на този коефициент е коректно, когато:
двете променливи са рангово скалирани признаци.
едната променлива е рангова, а другата количествена. В такъв случай предварително е необходимо количествената променлива да бъде трансформирана в рангова скала.
количествени променливи имат ненормално разпределение.
Стойността на коефициента се изчислява по формулата:
|
|
(4.3) |
Където: d – разлика в ранговите номера по Х и Y n – обем на извадката |
Коефициентът на рангова корелация на Спирмън има голямо приложение в
спортните игри и единоборствата, тъй като там спортния резултат е рангово скалиран.
При статистически проучвания изследователят се интересува от проявлението на зависимостите между явленията. Информацията, с която разполага, обикновено се базира на данни от извадка, а това означава, че стойността на коефициента на корелация може да бъде повлияна от случайни фактори.
Поради това се налага проверка на хипотезата за статистическата значимост на корелационния коефициент. Нулевата хипотеза гласи, че зависимост между изучаваните явления обективно не съществува, т.е. r=0, следователно емпиричният коефициент може да се счита за случаен.
За удобство в настоящото помагало прилагаме таблици с критични стойности на следните коефициенти:
Приложение 6 – Коефициент на обикновена линейна корелация на Пирсън (r) при степени на свобода k = n - 2 и равнище на значимост a= 0,05 и 0,01.
Приложение 7 – Коефициент на рангова корелация на Спирман (rs) при степени на свобода k = n - 2 и равнище на значимост a= 0,05 и 0,01.
В случай, че стойността на изчисления по данни от извадката коефициент на корелация е по-малък от критичната стойност, за вярна се приема нулевата хипотеза, която твърди, че няма зависимост между променливите величини.