|
Понятия
Изследваните
лица се различават (варират) по величината на
изследваните признаци. Вариацията е присъщо свойство на
статистическите съвкупности. Ако тя не съществуваше,
статистическите проучвания щяха да бъдат излишни. Тези
различия са породени от различни по своето естество
фактори, които най-общо се разделят на две категории:
-
закономерни, които действат еднакво върху всички
изучавани единици и определят типичното,
закономерното състояние на признака (например
типично, характерно за баскетболистите е, че имат
висок ръст).
-
случайни, които действат с различна сила върху
изучаваните единици и водят до индивидуални
отклонения във величината на признака (отделните
баскетболисти се различават по своя ръст).
Задача на
статистическото проучване е да даде обобщаващи
количествени характеристики на състоянието на
изследвания признак. За целта е необходимо, на първо
място, да се установи какво е типичното за дадената
съвкупност значение на признака, за да се опише
влиянието на закономерно действащите фактори. На
второ място, от особена важност е характеризиране на
разсейването, варирането на признаците, за да се отчете
влиянието на случайните фактори.
Горе
Показателите
за средно равнище представляват обобщаващи количествени
характеристики, с помощта на които се описва типичното,
характерното състояние на изследвания признак.
Най-често употребяваните показатели са
мода
(Mo),
медиана (Me)
и средна аритметична величина ( ).
-
Модата (Mo)
е стойността, която се повтаря най-голям брой пъти.
-
Медианата (Ме) е онази стойност на променливата
величина, която заема средно положение във
вариационния ред и го дели на две равни части.
Броят на стойностите, които са по-малки или равни на
медианата, е равен на броя на тези, които са
по-големи или съвпадат с нея.
-
Средната аритметична величина ()
е най-често използваният в научно-изследователската
практика показател за средно равнище. Изчислява се
по формула:
|
 |
3.1 |
Където:
SХ
- сума на стойностите
п –
обем на извадката |
Горе
Показателите
за разсейване дават количествена характеристика на
различията на стойностите. За измерване на статистическото
разсейване най-често се използват показателите размах
(R), стандартно отклонение (S), коефициент на вариация
(V).
|
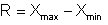 |
(3.2) |
където:
Xmax -
най-голямата стойност на
променливата
Xmin -
най-малката стойност на
променливата |
Тъй като в
изчисляването на размаха участват само двете крайни
стойности на вариационния ред, той е твърде
неустойчив измерител на разсейването.
|
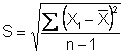 |
(3.3) |
където:
Xi
– всяка една стойност на променливата в
извадката
- средна
аритметична величина
п –
обем на извадката |
Изброените
статистически показатели за разсейване изразяват
степента на различията в същата мерна единица, в която е
изследваният признак. Това не дава възможност за
сравняване на вариацията на признаци, изразени в
различни мерни единици, а в случай че са в една и съща
мерна единица – относно различно средно равнище. За
разрешаване на проблеми от подобно естество в
статистиката се използва коефициентът на вариация (V
%). Той се изчислява по формула:
|
 |
(3.4) |
където:
S –
стандартно отклонение
- средна аритметична величина |
-
Коефициентът на вариация (V%)
дава информация за разсейването на признака,
изразено в проценти, което дава възможност за
сравняване на вариацията на различни признаци.
Освен това се ползва за оценяване на еднородността
на извадката:
-
Счита се, че разсейването на признака е малко (извадката
е еднородна), когато стойността му е до
10-12%.
-
Между
10 и 30% извадката е приблизително еднородна.
-
Когато е над 30% разсейването на признака е
голямо (извадката е силно нееднородна).
Горе
В настоящото
помагало многократно е използван терминът “разпределение
на признака”, с което се означава съответствието между
стойностите на променливата величина и тяхната абсолютна
или относителна честота. Тъй като статистическите
проучвания се основават на изследването на извадки, това
разпределение се нарича емпирично. Ако то се
онагледи графично, по конфигурацията на графичния образ
може да се съди за закономерността, на която е подчинено
изучаваната променлива величина, и да се търси аналог сред т.
нар. теоретични разпределения.
Изключително
важно място в теорията на статистиката заема
нормалното разпределение. То носи наименованието
Гаус-Лапласово по имената на немския математик Карл Гаус
(1777 – 1855) и френския математик Пиер Лаплас (1739 –
1827), които са го изследвали и описали теоретично.
Нормалното разпределение стои в основата на изясняване
на важни положения от репрезентативните статистически
проучвания, интервалното оценяване, проверката на
хипотези, методите за изготвяне на нормативи и др. Ще се
спрем накратко на някои негови особености:
Характерна за нормалното разпределение е камбановидната крива на
разпределение (фигура 3.1)- стойностите
около средното равнище на признака имат най-голяма
честота. Колкото повече се отдалечават от центъра на
разпределението – толкова по- рядко се срещат.


Фигура 3.1. Крива на
нормалното разпределение
Средната
аритметична величина ,
модата и медианата
са равни и се намират в центъра
разпределението.
Стандартното отклонение (S)
определя заостреността на кривата на
разпределение. Колкото отклоненията от средното
равнище са по-малки, толкова кривата е по-изострена и
обратно. На фиг. 3.2 са представени две емпирични
разпределения с еднаква форма и център, но с различно
разсейване.

Фигура 3.2.
Крива на разпределението при различно разсейване на
признака
Кривата на
нормалното разпределение е симетрична по отношение на
перпендикуляра, спуснат от нейния връх към абсцисата,
където се намира средната стойност.
На фигура 3.3 са представени три разпределения, едното
от които е симетрично (b),
а другите - несиметрични. Разпределение а е с дясно
изтеглено, а с - с ляво изтеглено рамо.
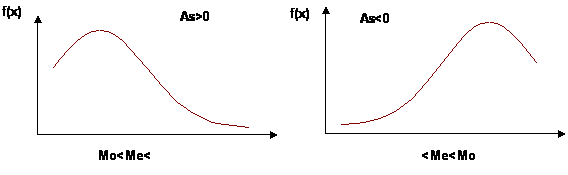
Фигура 3.3.
Симетричност на разпределението
Симетричността на разпределението се описва с показателя
за асиметрия (Аs), който при нормално
разпределение е равен на нула (As=0).
Когато коефициентът на асиметрия
е с положителен знак, кривата на разпределение е с дясно
изтеглено рамо (а), средната аритметична е
по-голяма от модата и медианата. При разпределение с
ляво изтеглено рамо (b)
стойността на коефициента на асиметрия е с отрицателен
знак, а средната аритметична е по-малка от модата и
медианата.
За
симетричността на емпиричното разпределение се съди по
изчисления от извадката по формула 3.5 емпиричен
коефициент на асиметрия (Asemp).
|
 |
(3.5) |
където:
m3
– трети централен момент, който
се
изчислява по формула 3.3
S
– стандартно
отклонение |
Третият
централен момент се изчислява по формула:
|
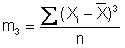 |
(3.6) |
където:
Xi
– всяка една стойност на променливата в
извадката
- средна
аритметична величина
п –
обем на извадката |
В
приложение
3 са дадени табличните стойности на
критерия (Asa)
в зависимост от обема на извадката (n) и
равнището на значимост (a).
В случай че:
Asemp
<
Asa
се
приема, че разпределението на емпиричните данни е
симетрично.
Asemp=>Asa
се счита, че
разпределението е несиметрично.
Височината на върха на нормалното разпределение се
описва с показателя ексцес (Ех), който при нормално
разпределение е равен на нула. На фигура 3.4 са
представени примерни разпределения с нормален (b),
висок - положителен (а) и нисък - отрицателен
ексцес (с).
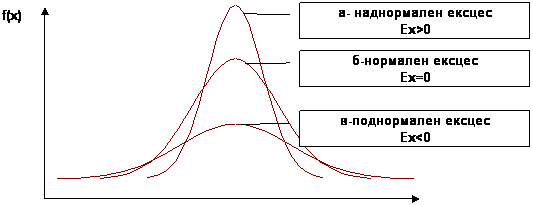
Фигура 3.4. Разпределения
с различна височина на върха
Информация
за степента на съвпадение на височината на върха на
емпиричното разпределение с приетия за еталон връх на
нормалното разпределение (Ex=0)
дава изчисленият по формула 3.7 емпиричен коефициент
на ексцес (Exemp).
|
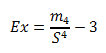 |
(3.7) |
където:
m4
– четвърти централен момент, който
се
изчислява по аналогичен на третия централен
момент начин, като разликите между всяка една
стойност на променливата и средната аритметична
се повдигат на четвърта степен
S
– стандартно
отклонение |
В
приложение
4 са дадени табличните стойности на
коефициента на ексцес (Exa)
в зависимост от обема на
извадката (n) и равнището на значимост (α).
В
случай че:
Exemp<
Exa
се
приема, че разпределението на емпиричните данни има
нормален ексцес.
Exemp=>Exa
се счита, че разпределението има ненормален ексцес.
 |
(3.8) |
|
В
приложение
5
са дадени стойностите на Z
и процентът от случаите (P%),
който попада в съответния интервал.

Фиг.3.5. Вероятност за попадане на случайната величина в
интервала от
X1
до
X2
Това важно свойство на нормалното разпределение намира
израз в т.нар. “правило на трите сигми”,
онагледено на фигура 3.3.
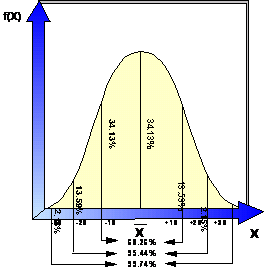
Фиг. 3.6.
От фигурата
се вижда, че в интервала:
-
От –1.S
до +1.S попадат
централните 68.26% от случаите (Z=1).
-
От –2.S
до +2.S попадат
централните 95.45% от
случаите (Z=2).
-
От –3.S
до +3.S попадат
централните 99.75%
от случаите (Z=3).
Вероятността дадена стойност на променливата
величина да е извън този интервал е 0,25%, което от
практическа гледна точка означава, че ако даден
признак има нормално разпределение, всички значения
на променливата попадат в границите на
±
3.S.
Свойствата
на нормалното разпределение имат голямо приложение в
научно-изследователската дейност в спорта и физическото
възпитание. Те дават възможност:
1.
Да се
изграждат нормативи по сигмалния метод. В таблица
3.1 са дадени границите и словесните оценки на
норматив по пет степенната скала на Щефко:
Таблица 3.1
|
Словесна оценка |
Р% |
Граници |
|
Ниска |
2.28% |
Под –2.S |
|
Под средна |
13.59% |
От –2.S
до -1.S |
|
Средна |
68.26% |
От –1.S
до +1.S |
|
Над средна |
13.59% |
От +1.S
до +2.S |
|
Висока |
2.28% |
Над +2.S |
2.
Да се оценява
всяко едно значение на променливата величина. За
целта се ползва т.нар.
Z-оценка,
която представлява нормираната стойност на
оценяваното значение (формула 3.8). Очевидно е, че
ако стойността на оценяваната величина е под
средното равнище, нейната
Z–оценка
е отрицателна. Ако съвпада с центъра на
разпределението,
Z
е 0, а ако е по-голяма от него -
положително число.
Горе |
 и
